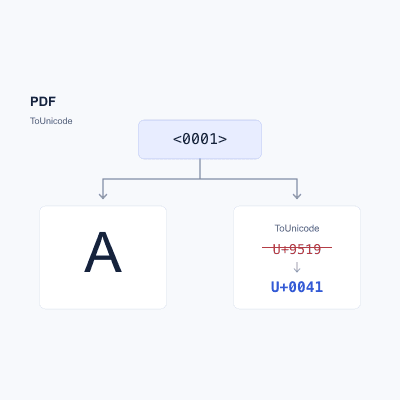
แก้ไขข้อความ PDF ที่อ่านไม่ออก: การแมปแบบอักษรและอธิบาย ToUnicode
ไฟล์ PDF ดูปกติดี แต่เมื่อคัดลอกข้อความ กลับกลายเป็นตัวอักษรเพี้ยน อาจเกิดจากการขาดหรือผิดพลาดของแผนที่อักขระเข้าใจบทบาทของ ToUnicode แยกแยะปัญหาของ OCR ตัวอักษร และลำดับการอ่าน จากนั้นจึงตัดสินใจวิธีแก้ไข
Oct 16, 2026